NGUYỄN THỊ TIÊU DAO
Chương I: Lời mời từ những “vùng xám”
Minh không bao giờ kể cho bạn bè về công việc thật của mình. Ở các quán cà phê Quận 1, anh chỉ nói mình là “cộng tác viên tự do về nội dung,” một câu trả lời an toàn và đủ mơ hồ để không ai hỏi thêm.
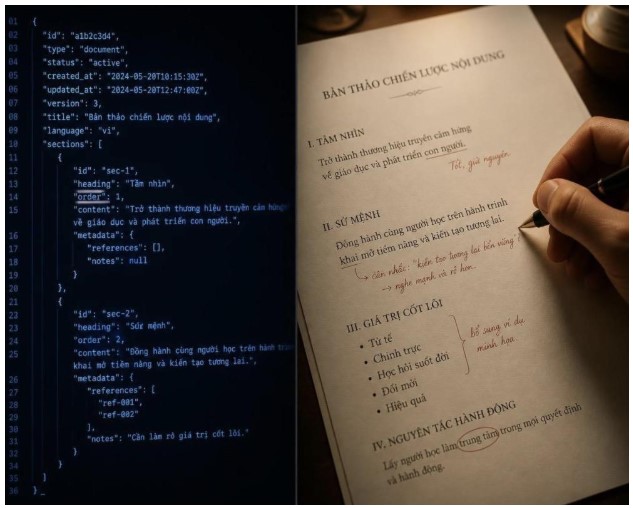
Thực ra, anh là một mắt xích trong chuỗi lao động đứng sau AI: những “con người trong vòng lặp” (human in the loop), người dạy máy nói tiếng Việt sao cho tự nhiên. Anh tìm được việc này qua một nhóm Facebook về việc làm remote cho người giỏi tiếng Anh, rồi qua một đường link dẫn đến cơ sở trực tuyến trung gian. Tiến trình tuyển chọn khá nhanh: một bài kiểm tra lỗi ngữ pháp, một bài viết về tư duy logic, và một buổi phỏng vấn qua Zoom với một người ở Phi Luật Tân.
Chương II: Làm “thầy giáo” cho máy
Mỗi ngày, Minh mở giao diện và thấy hai câu trả lời của AI cho cùng một câu hỏi. Chẳng hạn: “Tôi nên nói gì với sếp khi xin nghỉ phép vì lý do gia đình nhưng không muốn nói quá chi tiết?” Cột A đúng ngữ pháp nhưng lạnh như một thông báo. Cột B mềm mỏng hơn nhưng dùng “tôi” và “bạn” ngô nghê, lệch tôn ti công sở.
Anh phải chọn câu tốt hơn, hoặc viết một câu thứ ba. Anh cân nhắc nên dùng “em,” “con” hay “tôi,” và liệu cách nói có quá suồng sã không. Đó là công việc gắn nhãn và hoàn chỉnh. Anh không chỉ dạy AI tiếng Việt, mà đang dạy nó cách một người Việt giao tiếp.
Có những ngày nặng nề hơn. Để AI biết điều gì là độc hại, con người phải đọc trước những nội dung đó. Minh đã phân loại hàng trăm đoạn hội thoại đầy thù ghét và bạo lực, để người dùng cuối không bao giờ phải thấy chúng. Đó là một dạng lao động cảm xúc mà ít ai nhắc tới.
Chương III: Hai tầng và một tài khoản mong manh
Lực lượng lao động dữ liệu này chia thành hai tầng. Tầng đông nhất là lao động phổ thông, làm các tác vụ gắn nhãn theo task, thu nhập phụ thuộc khối lượng việc hoàn tất. Tầng ít hơn, gồm chuyên gia ngôn ngữ như Minh, làm việc RLHF (học tăng cường từ phản hồi của con người) và được trả lương cao hơn đáng kể. Với một người trẻ, con số này rất hấp dẫn. Nhưng mức lương khác nhau, tùy công việc và cơ sở tuyển dụng trực tuyến. Riêng OpenTrain hiện ghi tối đa 20 USD/giờ cho vị trí chuyên gia tiếng Việt.
Bảng phân loại lao động trí tuệ nhân tạo tại Việt Nam:

Minh là contractor, thuộc tầng lớp chuyên gia ngôn ngữ, lương cao so với tầng lao động phổ thông, song cũng không có bảo hiểm và không có hợp đồng dài hạn. Khi mô hình chatbot đủ giỏi, hoặc công ty đổi nhà cung cấp dữ liệu, tài khoản của anh có thể bị khóa sau một đêm.
Chương IV: Khi máy viết thơ
Một buổi tối, khi thử phiên bản mới của chatbot mà mình góp công huấn luyện, Minh gõ: “Hãy viết một bài thơ ngắn về nỗi buồn của một người làm việc trong bóng tối.“
Máy trả lời bằng một bài thơ mượt mà, đầy cảm xúc, dùng những hình ảnh mà chính Minh từng gợi ý trong một phiên làm việc tháng trước. Anh thấy vừa tự hào vừa lạnh sống lưng. Anh đang dùng trí tuệ, sự tinh tế và trải nghiệm của mình để dựng nên một thứ có thể thay thế chính công việc của mình.
Mỗi câu trả lời anh viết là một viên gạch dựng bức tường giữa con người và máy móc, nhưng cũng là chiếc cầu để máy bước qua và chiếm lấy không gian của con người.
Kết: Những bóng ma không tên
Câu chuyện của Minh là câu chuyện của hàng ngàn người Việt khác đang làm việc trong “vòng lặp.” Họ là những người vô danh đứng sau sự mượt mà của các câu trả lời AI. Họ không xuất hiện trong những bài báo ca ngợi công nghệ tiên tiến, nhưng nếu không có họ, AI vẫn chỉ là một cỗ máy dịch ngô nghê và vô hồn.
Họ được trả công cao hơn nhiều lao động ở một số nước châu Phi, nhưng vẫn đối mặt với sự cô độc và bất an của nền kinh tế gig. Liệu họ có thể liên kết để đòi quyền lợi, như công nhân kiểm duyệt nội dung ở Kenya đã làm qua việc thành lập công đoàn và các vụ kiện?
Lần tới khi chúng ta trầm trồ trước một chatbot “siêu thông minh,” hãy nhớ rằng đằng sau mỗi câu trả lời tinh tế là một con người, có thể là một sinh viên ở Hà Nội hay một biên tập viên ở Sài Gòn, đang lặng lẽ ngồi trước màn hình, sửa từng dấu phẩy và gọt từng từ để máy biết cách “hiểu” con người hơn.
[NtTD2026-11]
Câu chuyện này được tổng hợp dựa trên các cơ sở tuyển dụng thực tế của các nền tảng AI (như OpenTrain, Appen), các báo cáo về lao động kỹ thuật số tại Đông Nam Á và thực trạng kinh tế số tại Việt Nam.
Cùng một tác giả: https://www.toiyeutiengnuoctoi.com/category/tac-gia/a-to-h/nguyen-thi-tieu-dao/


